Uma stack de IA inteira numa RTX 3090 usada (e o que quebrou no caminho)
TL;DR
- O resultado: uma RTX 3090 de 24 GB, comprada usada no OLX, serve um assistente com visão e ferramentas, os modelos de busca nos meus documentos e geração de imagem, tudo dentro do Open WebUI. Nenhuma etapa passa por API de nuvem.
- O que fez caber: o Bonsai 2 27B, que é o Qwen3.8-27B comprimido para pesos ternários. A versão de 4 bits do mesmo modelo enchia a placa a 192K de contexto. A ternária roda 262K com os modelos de busca carregados ao lado.
- O que faz funcionar: um scheduler de VRAM. Chat e imagem se revezam na placa, e embeddings e reranker não saem.
- Quanto levou: 2 dias, em cima de uma infraestrutura que já rodava.
Em julho eu escrevi que isto não dava
No case do meu homelab, publicado em julho, eu escrevi que "24 GB não rodam modelo de fronteira, e eu não finjo que rodam". Para o modelo de fronteira de hoje, continua valendo. Para o de seis meses atrás, deixou de valer.
Em 14 de agosto a Alibaba lançou o Qwen3.8-27B, um modelo aberto de 27 bilhões de parâmetros. No model card oficial ele supera o Claude Opus 4.6 Max, que estava na fronteira em março, em 16 de 24 benchmarks. Ganha em código agêntico, em seguir instruções e em uso de computador. Perde em raciocínio de conhecimento (GPQA Diamond, Humanity's Last Exam). Os números são da própria Alibaba e não tinham reprodução independente no lançamento, então vale ler como teto.
O problema é o tamanho. Em FP16 o modelo tem 53,8 GB, mais que o dobro da placa. Em 4 bits ele cabe, mas ocupa tudo: o teto que medi foi 192K de contexto com os 24 GB cheios, sem espaço para os modelos de busca.
O modelo: pesos que valem −1, 0 ou +1
O Bonsai 2, da PrismML, é o mesmo Qwen3.8-27B comprimido para pesos ternários, com uma escala FP16 por grupo de pesos. O arquivo fica perto de 7 GB. Na minha placa, ele roda 262K de contexto em 13,0 GiB, contra os 24 GiB que a versão de 4 bits usava para 192K.
A pergunta seguinte é quanto se perde. Fiz um A/B ao vivo com 9 tarefas conferidas por execução ou por gabarito: código (merge de intervalos, busca binária com bug, LRU cache), problemas com armadilha, fatos distantes num contexto longo e visão densa com cálculo. Os dois acertaram as 9, com as mesmas respostas. A única diferença foi o tempo de raciocínio: a versão de 4 bits pensou cerca do dobro (22 contra 11 s no LRU cache). A PrismML diz que a perda aparece em loop longo de agente, e esse teste eu ainda não fiz. Até lá, a versão de 4 bits continua no catálogo para visão pesada.
Um detalhe que custa caro se passar batido: nenhuma versão do Bonsai 2 roda no llama.cpp oficial. Ele depende de uma transformação de ativação (Hadamard) que ainda não entrou no projeto principal e só existe no fork da PrismML. Duas das bandas publicadas falham com erro no llama.cpp oficial. A terceira carrega sem aviso e gera lixo. Hoje a máquina roda três builds do llama.cpp lado a lado: uma para embeddings e reranker, uma para o Qwen3.8 e o fork para o Bonsai.
O que roda na placa, e quando
Na frente dos modelos fica o llama-swap, um proxy que carrega e descarrega modelos sob demanda. Eu declaro quais conjuntos podem rodar juntos e um custo de despejo por modelo. Quando chega um pedido para um modelo que não cabe, ele despeja os mais baratos primeiro.
- Diário: embeddings + reranker + Bonsai 2. São 22,4 de 24,5 GB com os três carregados e respondendo. Só o Bonsai ocupa 20,3 GB, porque em produção o cache roda em q8_0 e carrega o enxerto descrito mais abaixo.
- Imagem: embeddings + reranker + ComfyUI. São 16,9 GB numa imagem de 1024×1024.
- Pesado: o Qwen3.8-27B em 4 bits, sozinho na placa, para visão de qualidade.
Embeddings e reranker têm o maior custo de despejo: 40, contra 10 do Bonsai e 20 do ComfyUI. Nos meus logs, pedido de embedding supera chat em 22 para 1, então esses dois só saem quando o modelo pesado pede a placa inteira.
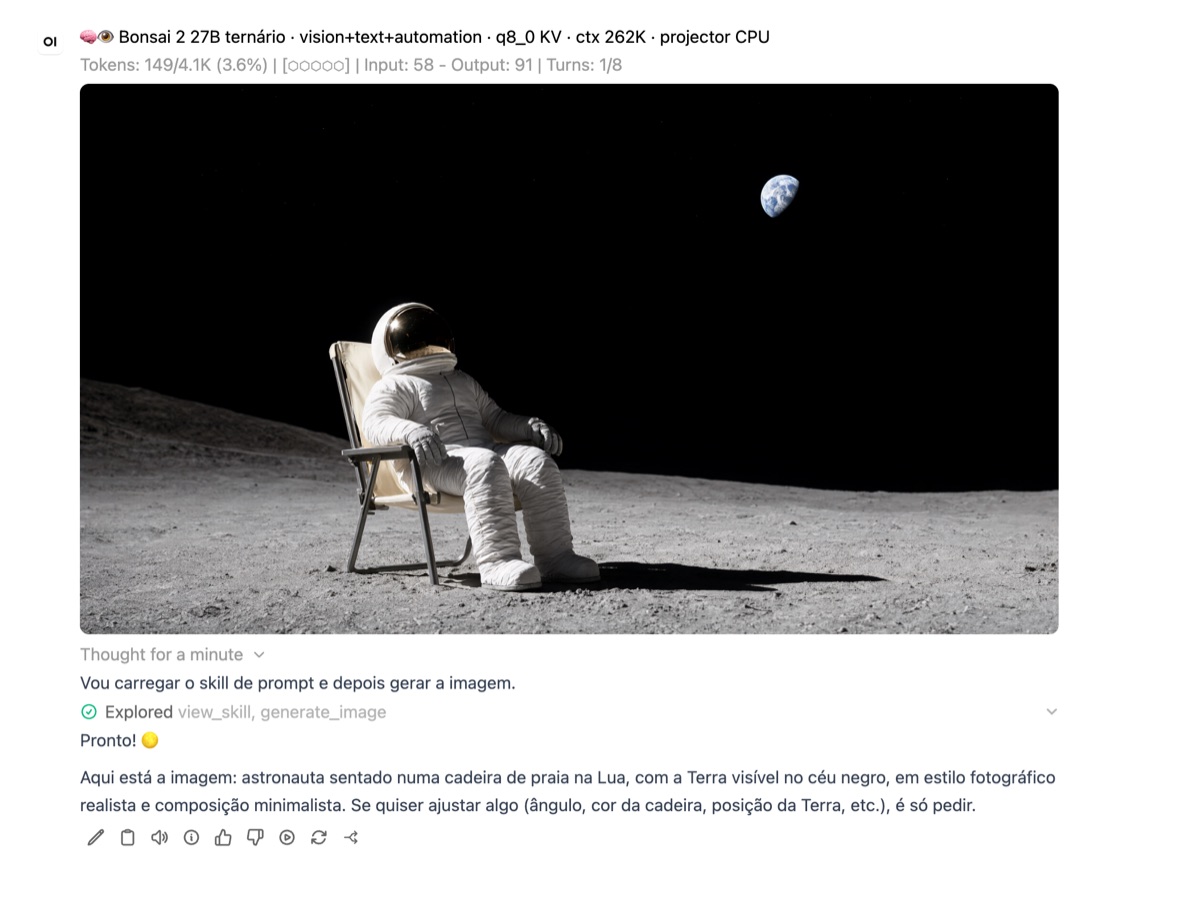
Quando peço uma imagem, o llama-swap tira o Bonsai e sobe o ComfyUI. Na pergunta seguinte, ele tira o ComfyUI e volta o Bonsai. No conjunto diário sobram 2,1 GB. Qualquer residente novo, ou mais contexto no Bonsai, exige medir de novo.
A imagem dentro do chat
O gerador é o Qwen-Image-2.1 em INT8 no ComfyUI: 7,26 GB de modelo de difusão, 9,35 GB de codificador de texto e 0,68 GB de VAE. Medido com embeddings e reranker carregados, uma imagem de 1024×1024 com 40 passos leva 49,96 s, e uma de 2048×1152 com 50 passos leva 95,39 s. Subir o ComfyUI a frio leva 11 s.
O modelo de chat não repassa a frase do usuário. Ele carrega uma skill de prompt e escreve
uma descrição de umas vinte frases, sempre em inglês, no formato em que o Qwen-Image foi
treinado. Depois chama generate_image, e a imagem aparece na conversa. A mesma
ferramenta tem edit_image, para alterar uma imagem enviada no chat.
O que quebrou
HTTP 409 em toda imagem
O gerador nativo do Open WebUI abre um websocket com o ComfyUI antes de mandar o pedido. O
llama-swap não sobe modelo em pedido de websocket. E o ComfyUI estava sempre fora da placa,
porque o modelo de chat tinha acabado de ocupá-la para escrever o prompt. Resultado: 409 em toda
imagem. A correção foi uma ferramenta própria, a qwen_image, que faz um GET simples
na raiz do ComfyUI antes de tudo. Esse pedido sobe o modelo e espera ele ficar pronto. As
ferramentas nativas de imagem ficaram desligadas por modelo, para o chat ver uma
generate_image e uma edit_image só.
O banco de dados sobrescreve o compose
A busca web do Open WebUI voltava vazia. O compose mandava usar o SearXNG, mas depois do primeiro boot o Open WebUI guarda a configuração no próprio banco, e o banco tinha outro motor de busca salvo. O banco vence a variável de ambiente. Corrigi direto no banco com o container parado, porque com ele rodando o Open WebUI reescreve a configuração da memória ao desligar.
A biblioteca CUDA errada
O instalador do fork escolhia o build para CUDA 12.8, que procura
libcudart.so.12, numa máquina com CUDA 13.2. Morria com "cannot open shared object".
O build para CUDA 13.3, com o caminho da biblioteca ajustado, rodou sem recompilar.
Um enxerto: +28% de velocidade com uma peça de outro modelo
O Qwen3.8 vem com uma cabeça de previsão de múltiplos tokens (MTP), usada em speculative decoding: uma parte barata do modelo propõe os próximos tokens e o modelo inteiro confere todos de uma vez. O Bonsai vem sem ela. Peguei a cabeça do Qwen3.8 de 4 bits que já estava em disco, 16 tensores e 1.066.172.160 bytes, e enxertei no Bonsai com as ferramentas do repositório bonsai2-small-gpu. O resto do modelo não mudou: remover o enxerto reproduz o sha256 do arquivo original, byte a byte.
- Velocidade: mediana de 60,1 para 77,2 tokens/s (1,28x). Em código, 85,6.
- Custo: o processamento do prompt fica entre 6% e 15% mais lento, e a folga de VRAM do conjunto diário caiu de 5,1 para 2,1 GB.
- Não é sem perda: 5 de 6 gerações longas divergem em algum ponto, porque os kernels do fork não dão o mesmo resultado numérico em lote e um token por vez. Numa bateria de 70 perguntas com gabarito, o resultado foi 56/70 com e sem o enxerto, e nenhum item mudou. As 14 falhas são todas multiplicação de 3 dígitos, um limite do modelo ternário e não do enxerto.
O que isso abre
- Privacidade: meus documentos são indexados e buscados na própria placa. Nada sai de casa.
- Custo: o job noturno que cruza o meu knowledge graph rodava em API de nuvem, pagava por chamada e batia em rate limit todo dia. Hoje custa eletricidade.
- Acesso: um modelo no nível da fronteira de seis meses atrás, com visão, ferramentas, busca e imagem, cabe numa placa de vídeo usada.
- Tempo: a base já existia (o llama-swap, os embeddings na GPU desde junho, o Open WebUI). Montar isto em cima dela levou 2 dias.
Referências
- PrismML-Eng/Bonsai-demoo repositório oficial do Bonsai 2, com o whitepaper e os scripts
- PrismML-Eng/llama.cppo fork do llama.cpp que roda os pesos ternários
- sudoingX/bonsai2-small-gpuas ferramentas do enxerto MTP
- mostlygeek/llama-swapo proxy que troca os modelos na placa
Outros cases
12 anos de homelab: minha stack de IA self-hosted LLM local em GPU, RAG híbrido, e um agente que pentesta o meu próprio SaaS. Um time de plataforma de uma pessoa só 60+ tenants, dois data centers, um engenheiro: por arquitetura. Migrando 50+ tenants em produção entre data centers, com zero downtime Réplica quente, cutover atômico, e prova por captura de pacotes, não por otimismo.Sempre aberto a trocar ideia com quem opera infraestrutura de verdade.
LinkedIn